
Kategoria: Lokalne AI
Od 45,7 do około 3,5 tokena na sekundę, zależnie od modelu: tyle wyciąga Radeon 890M w modelach językowych na mojej maszynie. Najciekawsza jest w tej odpowiedzi rozpiętość, a karta katalogowa jej nie podaje.
Wszystkie liczby poniżej pochodzą z jednej maszyny: AMD Ryzen AI 9 HX 470, 24 rdzenie, zintegrowana grafika Radeon 890M, dysk NVMe 1 TB. Prędkości generowania to seria pomiarów z września 2026 na dwudziestu trzech modelach, silnikiem jest llama.cpp. Odczyty dotyczące pamięci grafiki pochodzą z października 2026. To jedna konfiguracja, nie klasa urządzeń.
Skąd zintegrowana grafika bierze pamięć na model
Radeon 890M nie ma własnych gigabajtów wlutowanych na płytce. Dostaje wycięty kawałek pamięci systemowej i tylko w nim może trzymać wagi modelu. Mówi się o tym „bez dedykowanej karty graficznej”, co bywa czytane jako „bez grafiki”, a to nieprawda: grafika jest, po prostu pożycza pamięć.
Okno firmware, nie VRAM
U mnie firmware wystawia na to okno około 19 GB (odczyt, październik 2026). Ta jedna liczba, nie suma zainstalowanej pamięci, wyznacza górny pułap modelu liczonego na grafice. Sprawdziłem też, czy okno rośnie razem z RAM-em: po przejściu z 32 na 64 GB zostało takie samo, co opisałem osobno w tekście o tym, dlaczego okno pamięci grafiki nie zmieniło się po rozbudowie RAM-u.
Zmierzone tokeny na sekundę, trzy klasy wyniku
Z dwudziestu trzech modeli nie wychodzi jedna liczba, tylko trzy wyraźnie rozdzielone grupy. Granica między nimi nie przebiega po rozmiarze pliku.
Od 45,7 do około 3,5 tokena na sekundę
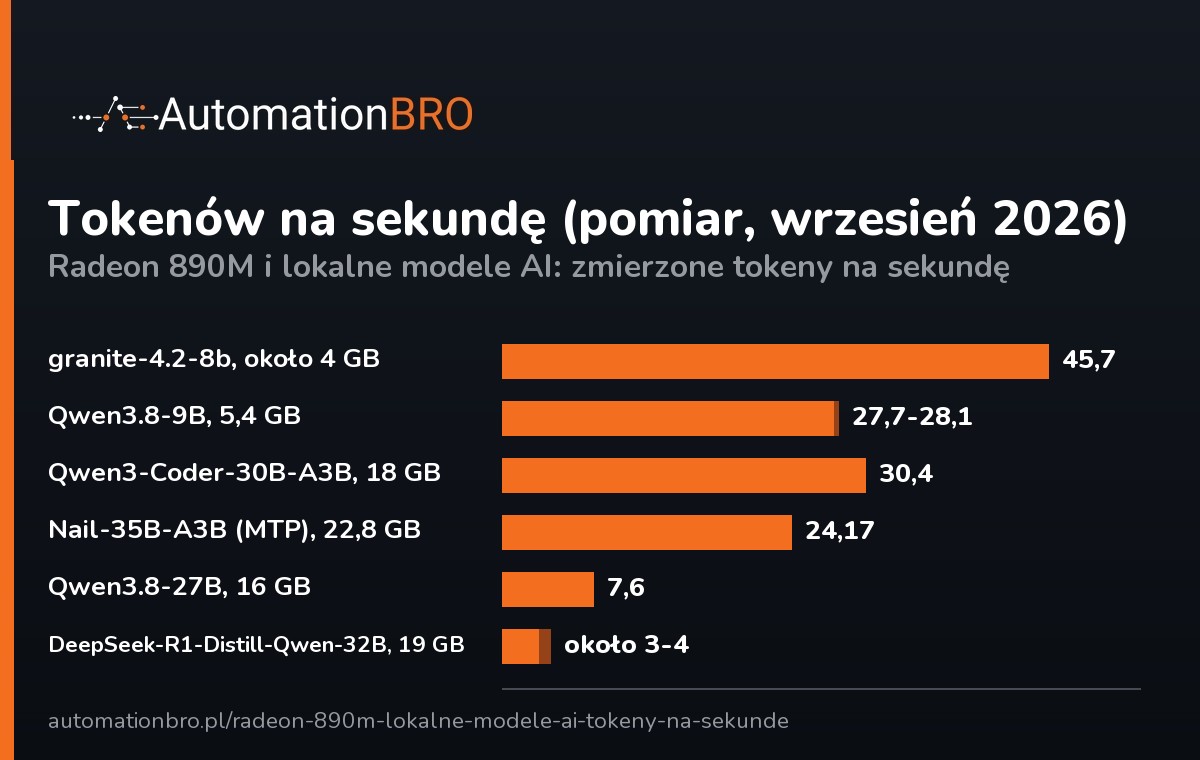
| Klasa modelu | Przykład i rozmiar pliku | Tokenów na sekundę (pomiar, wrzesień 2026) |
|---|---|---|
| Gęsty do 9 mld parametrów | granite-4.2-8b, około 4 GB | 45,7 |
| Gęsty do 9 mld parametrów | Qwen3.8-9B, 5,4 GB | 27,7-28,1 |
| Mieszanka ekspertów, około 3 mld aktywnych | Qwen3-Coder-30B-A3B, 18 GB | 30,4 |
| Mieszanka ekspertów, około 3 mld aktywnych | Nail-35B-A3B (MTP), 22,8 GB | 24,17 |
| Gęsty powyżej 9 mld, długi kontekst | Qwen3.8-27B, 16 GB | 7,6 |
| Gęsty powyżej 9 mld, długi kontekst | DeepSeek-R1-Distill-Qwen-32B, 19 GB | około 3-4 |
Reguła z tej tabeli jest krótsza niż ona sama. Jedenaście z trzynastu wierszy z mieszanką ekspertów mieści się w przedziale 21-33 tokena na sekundę, a dwa spadają niżej, do 16,3 i 17,86, i oba mają w nazwie „35B”. W przebiegach z długim kontekstem każdy wiersz gęsty powyżej 9 mld parametrów schodzi do 11,3 tokena na sekundę lub niżej. Jest przy tym wyjątek, o którym trzeba powiedzieć w tym samym zdaniu: gemma-4-12b na krótkim, rozgrzanym zapytaniu dochodzi u mnie do 34 tokenów na sekundę. Mechanizm tej różnicy rozpisałem na liczbach w tekście o tym, dlaczego model 30B potrafi być szybszy niż 12B.
Co faktycznie robi przeniesienie warstw na grafikę
To jest moment, w którym Radeon 890M przestaje być pozycją w specyfikacji i zaczyna coś robić.
Parametr ngl i granica okna
Warstwy modelu da się przerzucić z procesora na grafikę, a w części modeli z mojej serii trafiają tam wszystkie; odpowiada za to parametr -ngl ustawiony na 99. Dopóki wagi mieszczą się w oknie, przyspiesza to odpowiedź około 3-6 razy (pomiar z mojej maszyny), a po przekroczeniu okna nadwyżka liczy się na magistrali pamięci. Łatwo wyciągnąć z tego wniosek, którego moja własna tabela nie potwierdza: pliki o rozmiarze 21 i 22,8 GB są większe od okna, a mimo to osiągają 30,4 i 24,17 tokena na sekundę. O wyniku decyduje więc nie rozmiar pliku, tylko liczba parametrów przeliczanych na jeden token. W mieszance ekspertów aktywne są około 3 miliardy i nadwyżka poza oknem kosztuje wtedy niewiele. Model gęsty przelicza w każdym kroku wszystkie wagi, więc opiera się o przepustowość pamięci nawet wtedy, gdy mieści się w oknie w całości: gęsty Qwen3.8-27B ma 16 GB, czyli mieści się, i zatrzymuje się na 7,6 tokena na sekundę. Całą warstwę oprogramowania wokół tego, czyli system bez pulpitu, silnik i bramę API, opisałem w tekście o tym, jak uruchomić lokalny model AI na Ubuntu Server.
Dlaczego nazwa modelu nie przewiduje wyniku
Gdyby wynik dawało się odczytać z nazwy, cała ta seria pomiarów byłaby niepotrzebna. Nie daje się, i mam na to dwa dowody z własnej tabeli.
Najszybszy model na tej grafice jest najmniejszym plikiem
Najwyższy wynik w całej tabeli należy do granite-4.2-8b: 45,7 tokena na sekundę przy pliku o rozmiarze około 4 GB, czyli najmniejszym, jaki na tej maszynie mierzyłem. Żaden z dużych plików nawet się do tej liczby nie zbliża.
Drugi dowód mieści się w jednej rodzinie modeli. Sześć moich wierszy Qwen ma praktycznie ten sam poziom kompresji, od 4,7 do 5,1 bita na wagę, a ich prędkości rozciągają się od 30,4 do około 3,5 tokena na sekundę. Ten sam producent, ten sam sposób zapisu pliku, rząd wielkości różnicy w wyniku. Zdarza się przy tym, że nawet dwa wydania tego samego pliku generują z różną prędkością, co pokazałem na liczbach w linkowanym wyżej tekście o uruchamianiu modelu. Jak dobieram model pod tę maszynę, rozpisałem w tekście o tym, jaki model AI uruchomisz lokalnie na mini PC.
Ile to znaczy w praktyce i ile pobiera prądu
Benchmark bez punktu odniesienia niczego nie rozstrzyga, więc dwa odniesienia.
Powyżej 10 tokenów na sekundę przestaje się czekać
Człowiek czyta w tempie około 4-5 tokenów na sekundę. Powyżej 10 tekst pojawia się szybciej, niż da się go przeczytać, więc czekanie przestaje być odczuwalne. Na tej grafice próg ten przekracza wszystkie trzynaście wierszy z mieszanką ekspertów, bo najniższy z nich ma 16,3, oraz obie pozycje gęste do 9 mld parametrów. Nie przekraczają go modele gęste powyżej tej granicy w długim kontekście. Druga liczba to pobór: cała maszyna bierze 3-8 W w stanie jałowym i około 130 W pod pełnym obciążeniem, a pełne wyliczenie rachunku zrobiłem w tekście o tym, ile prądu zużywa domowy serwer AI.
Jedna maszyna, jedno firmware, brak porównań z kartami
Nie porównałem Radeona 890M z żadną dedykowaną kartą graficzną ani z poprzednim układem zintegrowanym, bo żadnego z nich nie mam na biurku. Liczby obok siebie z dwóch różnych recenzji nie są pomiarem, więc ich tu nie będzie.
Okno 19 GB to odczyt z mojej konfiguracji, nie specyfikacja producenta. Na innej płycie może być konfigurowalne, a inny sterownik może raportować je inaczej.
Wszystkie prędkości powyżej dotyczą generowania, nie wczytywania zapytania. Czasu przetwarzania promptu nie mam w żadnym przebiegu, a przy długim kontekście to on decyduje o tym, kiedy pojawi się pierwszy token.
Nie zmierzyłem też, ile kosztuje w jakości odpowiedzi obniżona precyzja, w której te pliki są zapisane. Tokeny na sekundę mówią, jak szybko model odpowiada, i nie mówią nic o tym, czy odpowiada dobrze.
Pełne wyniki tych pomiarów są publiczne. Tabela 23 modeli, ten sam zestaw w pliku CSV oraz skrypt, którym mierzyłem prędkość, leżą w repozytorium local-llm-speed-igpu na GitHubie. Repozytorium jest w języku angielskim.

