
Kategoria: Automatyzacja i autonomia
Przez dwa lata nie zajrzałem do dziennika przebiegów własnej instancji n8n. Odpowiedź na „ile razy to zawiodło?” leżała tam cały czas i nie miałem jej tylko dlatego, że jej nie poszukałem.
Pracuję na jednej instancji n8n uruchomionej na własnym serwerze domowym, z bazą PostgreSQL pod spodem. n8n zapisuje każde uruchomienie automatyzacji jako wiersz w tabeli przebiegów, wraz z datą, czasem trwania i statusem. Liczby w tym tekście odczytałem bezpośrednio z tej tabeli 30 października 2026. Dotyczą 14 dni, ponieważ dokładnie tyle historii moja instancja przechowuje.
Dziennik, który n8n prowadzi samodzielnie
Najważniejsza właściwość tego dziennika nie jest moją zasługą: nie musiałem niczego włączać. Każdy przebieg każdego workflow zostawia wiersz. Dzięki temu odpowiedź na pytanie o liczbę niepowodzeń nie jest wspomnieniem ani wrażeniem, lecz wartością, którą można policzyć dwukrotnie i porównać wyniki.
Różnica między wrażeniem a licznikiem jest właściwym tematem tego tekstu. Pamiętam dwie, może trzy sytuacje, w których automatyzacja wyraźnie nie zadziałała. Tabela zawiera ich ponad tysiąc. Obie wartości są prawdziwe, ponieważ mierzą co innego.
Trzy statusy, nie dwa
Spodziewałem się dwóch: udanego i nieudanego. W tabeli są trzy. Trzeci opisuje przebieg oczekujący: workflow zatrzymał się w połowie, ponieważ zawiera blok wstrzymujący, i stoi do momentu, w którym coś go obudzi. Taki wiersz nie jest ani sukcesem, ani błędem, i trzeba go liczyć osobno, ponieważ w przeciwnym razie zniekształca każdy wskaźnik.
Czternaście dni, ponad pięć tysięcy przebiegów
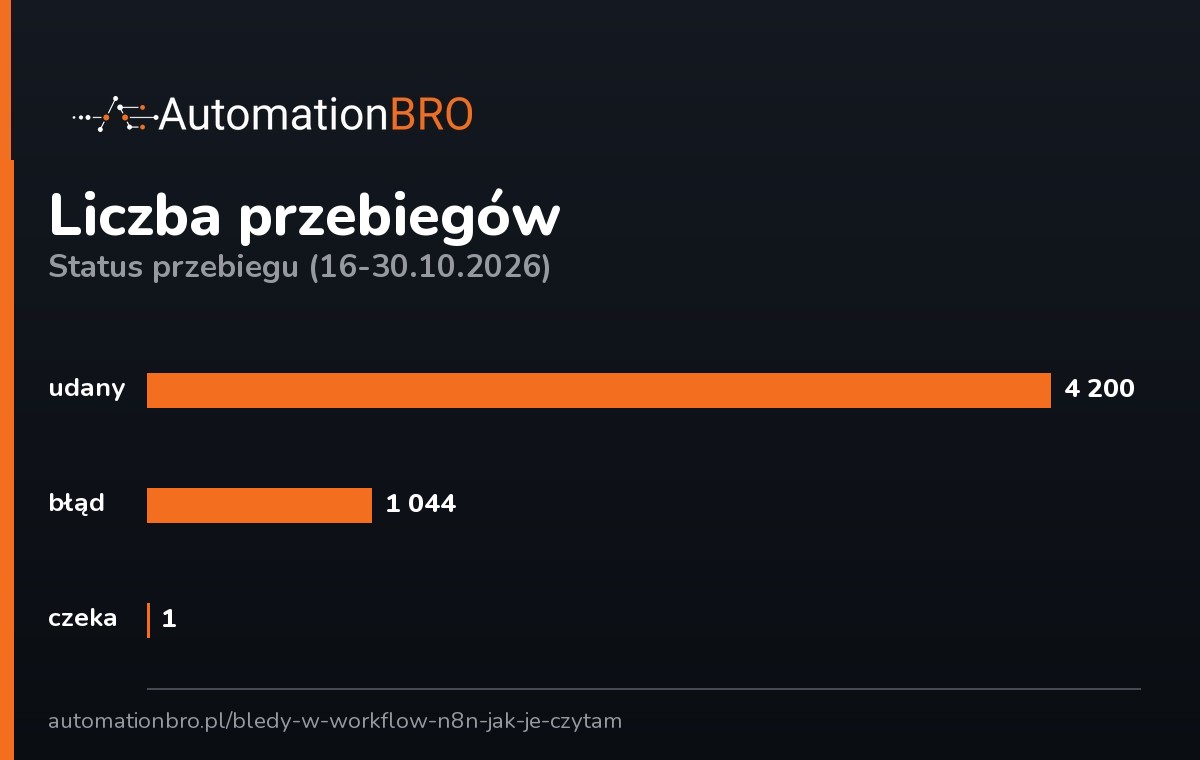
| Status przebiegu (16-30.10.2026) | Liczba |
|---|---|
| udany | 4 200 |
| błąd | 1 044 |
| czeka | 1 |
| razem w dzienniku | 5 245 |
Wszystkie trzy wartości pochodzą z jednego odczytu i sumują się do czwartej. Wynika z nich około 375 przebiegów na dobę (wyliczenie: 5 245 podzielone przez 14 dni, nie pomiar tempa; w rzeczywistości ruch nie rozkłada się równomiernie, ponieważ większość tych automatyzacji startuje z harmonogramu o ustalonych godzinach). Harmonogram jest u mnie najczęstszym wyzwalaczem reagującym na świat zewnętrzny i policzyłem go razem z pozostałymi w tekście o tym, co uruchamia automatyzację.
Dlaczego 14 dni, a nie dwa lata
Ponieważ n8n usuwa starsze wiersze. Najstarszy przebieg w całej tabeli pochodzi z 16 października, a instancja pracuje od grudnia 2024, więc historia nie zaczyna się w tym miejscu, tylko w nim kończy. Przy 375 przebiegach dziennie przechowywanie wszystkich oznaczałoby kilkaset tysięcy wierszy rocznie w bazie, która ma inne zadania. Nie odczytałem, jaka wartość wyznacza tę granicę na mojej instancji, więc nie podaję jej z pamięci. Podaję to, co wynika z danych: dziennik przebiegów jest pamięcią krótkoterminową i nie nadaje się do porównań rok do roku. Takie porównania wymagają zapisywania podsumowań obok, podobnie jak działa u mnie osiem baz danych z jedną drogą dostępu.
Co piąty przebieg kończy się błędem
Udział wierszy z błędem wynosi 19,9 % wszystkich przebiegów z tych 14 dni (wyliczenie z tabeli powyżej). Podaję go z zastrzeżeniem, ponieważ dysponuję dwoma odczytami, które nie schodzą się do jednej wartości: zapytanie z filtrem czasu zwraca 1 044 błędy, a to samo zapytanie bez filtra zwraca 1 098, mimo że cała tabela i tak mieści się w oknie. Tych 54 wierszy nie potrafię na razie wyjaśnić, więc nie wybieram wartości wygodniejszej. Rzeczywisty udział błędów leży między 19,9 % a 20,7 %, a na obu krańcach tego przedziału brzmi tak samo: co piąty przebieg.
Dlaczego nie zaokrąglam tej wartości w dół
Ponieważ jest to kuszące. Proporcja jeden na pięć wygląda źle obok zdania o systemie, który działa, a pierwszą myślą było policzenie jej inaczej: na przykład wyłącznie dla workflow włączonych albo z pominięciem tych, o których wiem, że zawodzą z przyczyny dla mnie nieistotnej. Każde takie przeliczenie jest dobieraniem próbki pod z góry założony wynik. Opisałem wcześniej, jak nie udało mi się zmierzyć czasu, który oszczędza mój system, a najgorszym momentem tamtej historii był dokładnie ten sam mechanizm: wartość, której nikt nie zweryfikuje, rośnie w stronę wygodną dla autora. Pozostaje zatem 19,9 %.
Wiersz z błędem i awaria to dwa różne zdarzenia
Tysiąc czterdzieści cztery błędy w ciągu 14 dni, a ja pamiętam dwie sytuacje, w których coś rzeczywiście nie zadziałało. Nie ma w tym sprzeczności. Wiersz z błędem oznacza, że jeden blok w jednym przebiegu zwrócił dane, których n8n nie potrafił przetworzyć: wygasł token, usługa po drugiej stronie odpowiedziała błędem, arkusz nie zawierał spodziewanego wiersza. Awaria jest czymś innym, ponieważ jest momentem, w którym człowiek zauważa, że usługa nie działa. Jedno nie wynika z drugiego w żadną stronę.
Rozróżnienie to jest na tyle istotne, że poświęciłem mu osobny tekst o tym, jak rozstrzygam, czy mam do czynienia z awarią, czy ze zmianą. Tabela przebiegów nie odpowiada na to pytanie i nie służy do tego. Informuje wyłącznie o tym, że w danym miejscu coś się przerwało.
Jedna wartość, która mówi więcej niż udział
Te 1 044 błędy rozkładają się na 31 różnych workflow. Włączonych mam 119, więc błąd dotknął nieco ponad jednej czwartej tego, co w ogóle nasłuchuje, a nie całego zbioru. Pochodzenie liczby 119 oraz los pozostałych pozycji wyjaśniam w tekście o tym, co znaczy ponad 150 workflow w n8n. Zmienia to rodzaj pracy, którą trzeba wykonać: nie przeglądam 119 automatyzacji, lecz otwieram listę trzydziestu jeden. Rozmiar tych workflow policzyłem osobno i mediana wynosi dwanaście bloków. Nie wiem natomiast, jak te 1 044 błędy dzielą się wewnątrz owej trzydziestki jeden. Jeżeli jeden workflow zawodzi co godzinę, odpowiada samodzielnie za ponad 300 wierszy i cały obraz jest inny niż przy rozkładzie równomiernym. Tego podziału nie odczytałem, a dopóki go nie mam, nie twierdzę, że znam przyczynę choćby jednego z tych błędów.
Zero ponowień jest ustawieniem, nie przypadkiem
Żaden z tych 1 044 nieudanych przebiegów nie został powtórzony automatycznie (pomiar: zero wierszy oznaczonych jako ponowienie). W n8n ponowienie jest ustawieniem pojedynczego bloku i domyślnie pozostaje wyłączone, więc zero w tej kolumnie oznacza dokładnie jedno: nie włączyłem go nigdzie. Przebieg, który napotkał błąd, zatrzymał się i na tym zakończył.
Gdzie ponowienie pomaga, a gdzie szkodzi
Pomaga w jednym przypadku: gdy przyczyna jest chwilowa, a operacja jest bezpieczna do powtórzenia. Odczyt z arkusza, zapytanie do API czy pobranie pliku można ponowić trzykrotnie bez żadnych skutków ubocznych. Szkodzi wszędzie tam, gdzie blok coś zmienia: wysyła wiadomość, dopisuje wiersz, wykonuje przelew, włącza urządzenie. Trzykrotnie powtórzone wysłanie daje u odbiorcy trzy wiadomości zamiast jednej. Dlatego nie zamierzam włączać ponowień globalnie, ponieważ jest to decyzja podejmowana dla każdego bloku osobno. Ten sam rachunek pojawia się przy wersjonowaniu automatyzacji: każde rozwiązanie działające samodzielnie musi mieć opisaną drogę powrotną.
Trzy wartości, które czytam zamiast jednej
Poniższe zapytanie pozwala odczytać te same wartości w dowolnej instancji n8n z bazą PostgreSQL. Służy wyłącznie do odczytu i niczego nie zmienia:
SELECT status, count(*) AS przebiegi, min("startedAt") AS najstarszy, max("startedAt") AS najnowszy FROM execution_entity GROUP BY 1 ORDER BY 2 DESC;Czytam z niego trzy rzeczy w ustalonej kolejności, która ma znaczenie:
- Najstarszą datę, czyli rzeczywistą głębokość dziennika. Bez niej każdy wskaźnik dotyczy nieznanego okresu. To właśnie na tej wartości sam się potknąłem: wyszedłem od trzydziestu dni, a miałem czternaście.
- Udział błędów, zawsze razem z liczbą przebiegów oczekujących, ponieważ nie należą one do żadnej z dwóch głównych grup.
- Liczbę różnych workflow z błędem, ponieważ zamienia ona wartość nie do ogarnięcia w listę do przejrzenia.
Wniosek dla kogoś, kto zaczyna
Jest tylko jeden: do tabeli przebiegów warto zajrzeć wcześniej niż po dwóch latach, i nie po to, by poprawiać wynik, lecz po to, by mieć punkt odniesienia. Udział błędów rzędu dwudziestu procent sam w sobie nie rozstrzyga, czy system działa dobrze, czy źle. Mówi, ile system zawiera kroków, które wolno przerwać bez konsekwencji. Dopóki nie wiadomo, które to są, rozmowa o jego jakości nie ma podstawy.
Czternaście dni i jedna niewyjaśniona różnica
Ograniczenia zbieram w jednym miejscu, żeby nie trzeba było ich wyszukiwać w tekście:
- Dotyczą 14 dni. Nie roku i nie całego okresu pracy instancji. Dziennik przebiegów jest czyszczony, a starszych danych po prostu nie ma.
- Udział błędów jest przedziałem. Od 19,9 % do 20,7 %, ponieważ dwa odczyty tej samej tabeli różnią się o 54 wiersze, których nie wyjaśniłem.
- Nie znam przyczyny żadnego z tych błędów. Status informuje, że przebieg się przerwał, a nie dlaczego. Przyczyny znajdują się w treści przebiegów, a tej nie czytałem.
- Nie wiem, jak błędy rozkładają się na te 31 workflow. Możliwe, że odpowiada za nie kilka pozycji, co zmieniłoby wnioski.
- Nie wiem, ile z nich ktokolwiek zauważył. Błąd w dzienniku nie jest awarią usługi, a ten tekst nie łączy jednego z drugim.
- Nie ma tu żadnej wartości opisującej czas ani koszt. Dziennik przebiegów ich nie mierzy.
- Opisują jeden odczyt. 30 października 2026. Za dwa tygodnie w tabeli znajdzie się zupełnie inny zbiór wierszy, ponieważ obecny zostanie usunięty.
Otwarte pozostaje pytanie, do którego wrócę po odczytaniu podziału: czy te 31 workflow to trzydzieści jeden drobnych usterek, czy trzy pozycje psujące się bez przerwy. Odpowiedź zmienia wszystko poza wartością 19,9 %.

