
Kategoria: Lokalne AI
„LM Studio czy llama.cpp?” To pytanie zakłada rzecz, która nie jest prawdą: że wybiera się między dwoma silnikami. Wybiera się między aplikacją i tym, co w tej aplikacji siedzi pod spodem.
Mówię to na podstawie jednej konfiguracji, którą prowadzę od miesięcy, i jednego faktu o samym oprogramowaniu. Silnikiem jest u mnie llama.cpp na mini PC z zintegrowaną grafiką, a na tej maszynie powstała moja seria pomiarów dwudziestu trzech modeli z września 2026. LM Studio uruchamiałem u siebie wcześniej, ale wtedy go nie mierzyłem i nie mam dziś tej instalacji pod ręką, więc prędkości ani funkcji tu nie porównuję. Ograniczenia tego tekstu zbieram na końcu.
Co jest czym
LM Studio korzysta z llama.cpp
Podałem to już, zbierając metody przyspieszania generowania: zarówno LM Studio, jak i Ollama mają pod spodem tę samą bibliotekę, więc nowe mechanizmy pojawiają się u nich wtedy, gdy zaktualizują silnik. Najlepiej widać to na przykładzie, który tam rozpisałem: generowanie wielu tokenów naraz weszło do llama.cpp 16 maja 2026 zgłoszeniem numer 22673, a w LM Studio jest przełącznikiem w sekcji poświęconej generowaniu spekulatywnemu. Cały ten przegląd jest w tekście o metodach przyspieszania lokalnego modelu.
Z tego wynika sposób czytania całego pytania. Po jednej stronie jest biblioteka i serwer, które liczą tokeny. Po drugiej aplikacja, która tę samą bibliotekę pakuje w okno, dokłada pobieranie plików, listę modeli i ustawienia na suwakach. Są to dwa różne poziomy, a nie dwie konkurencyjne implementacje.
Dlaczego pytanie o prędkość trafia w złą warstwę
Prędkość, którą zmierzyłem, jest prędkością silnika
Skoro pod spodem pracuje ta sama biblioteka, to prędkość generowania jest własnością silnika, pliku modelu i maszyny, a nie interfejsu. Moje 45,7 tokena na sekundę na najszybszym modelu i 7,6 na gęstym modelu 27B (pomiar z września 2026) są liczbami llama.cpp, bo tym silnikiem je mierzyłem.
Nie znaczy to, że dwie instalacje muszą dać ten sam wynik. Znaczy, że jeżeli dadzą różny, to nie dlatego, że jedna z nich jest „szybszym silnikiem”, a dlatego, że mają inną wersję biblioteki, inaczej ustawione przenoszenie warstw na grafikę albo inny plik modelu. Dwie pierwsze rzeczy sprawdza się w ustawieniach, trzecią w nazwie pliku, i żadna z nich nie jest cechą marki.
Co u mnie rozstrzygnęło tę decyzję
Ubuntu Server bez pulpitu, około 400 MB pamięci
U mnie decyzja zapadła poziom niżej, niż brzmi pytanie: najpierw o systemie, dopiero potem o oprogramowaniu. Maszyna liczy modele i nie robi nic innego, więc stoi na niej Ubuntu Server w instalacji minimalnej, bez pulpitu, i łączę się z nią z innego komputera. Rozpisałem tę instalację warstwa po warstwie, opisując uruchomienie lokalnego modelu na llama.cpp i LiteLLM.
Powód jest w jednej kolumnie liczb. Pamięć na tej maszynie jest wspólna dla procesora i grafiki, więc wszystko, co zajmie system, zabiera modelowi:
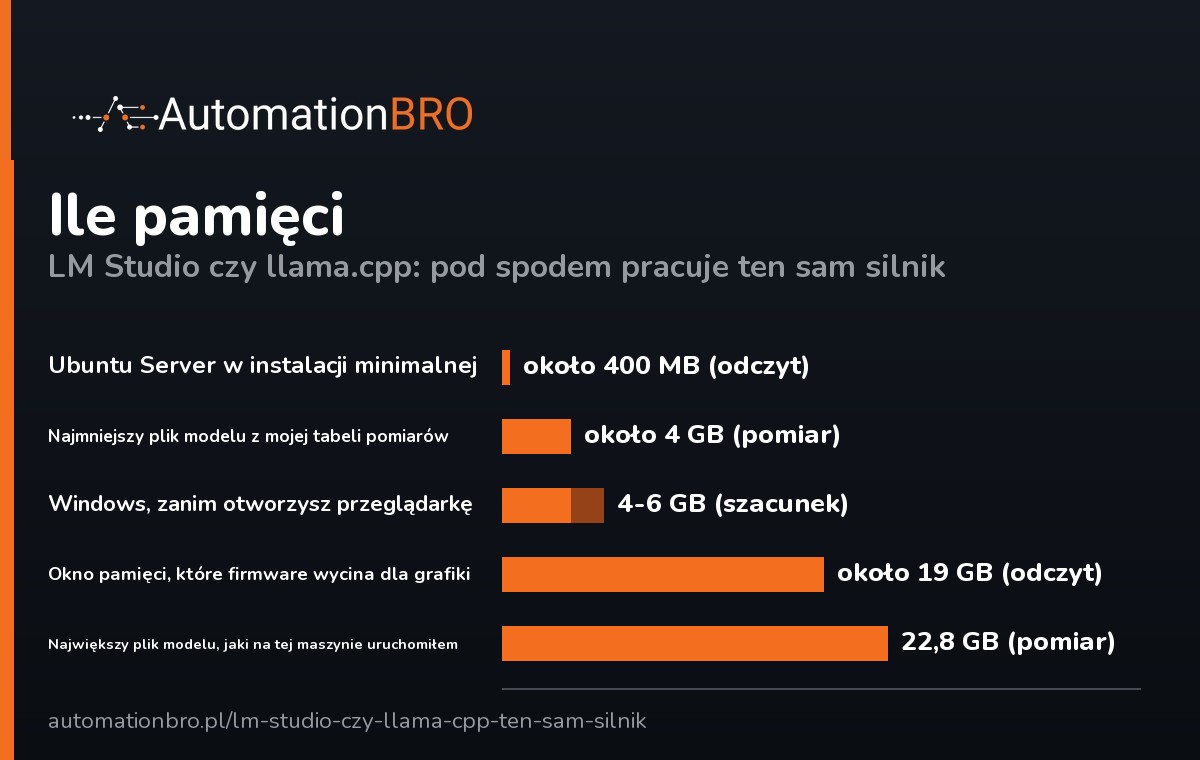
| Co | Ile pamięci |
|---|---|
| Ubuntu Server w instalacji minimalnej | około 400 MB (odczyt) |
| Windows, zanim otworzysz przeglądarkę | 4-6 GB (szacunek, podany przeze mnie przy tej instalacji) |
| Najmniejszy plik modelu z mojej tabeli pomiarów | około 4 GB (granite 4.2 8B, pomiar, wrzesień 2026) |
| Największy plik modelu, jaki na tej maszynie uruchomiłem | 22,8 GB (pomiar, wrzesień 2026) |
| Okno pamięci, które firmware wycina dla grafiki | około 19 GB (odczyt, październik 2026) |
Pierwsze dwa wiersze różnią się o rząd wielkości, a trzeci i czwarty pokazują, na co ta różnica idzie. Plik najszybszego modelu na tej maszynie waży przy tym tyle, ile sam Windows zajmuje, zanim otworzysz przeglądarkę. Ostatniego wiersza nie powiększa przy tym dołożenie kości pamięci: sprawdziłem to przy przejściu na 64 GB, a wynik opisałem osobno, pytając, co daje więcej RAM-u, a czego nie zmienia pamięć iGPU.
Co dostaje się z samego silnika
Dwadzieścia trzy modele, bo serię pomiarów da się zapętlić
Sam silnik daje jedną rzecz, której w moim przypadku nic nie zastąpiło: uruchamia się poleceniem, więc dwudziestu trzech modeli nie trzeba było mierzyć po jednym, ręcznie. Cała moja tabela prędkości powstała w ten sposób i podałem ją model po modelu przy pytaniu, jaki model AI uruchomisz lokalnie na mini PC.
Z tej samej serii wyszła obserwacja, która jest dziś moim głównym argumentem za mierzeniem u siebie, niezależnie od tego, co kto zainstaluje. Dwa wydania pliku jednego modelu rozeszły się u mnie o ponad sześć tokenów na sekundę, przy różnicy rozmiaru pliku poniżej dwóch procent (pomiar, wrzesień 2026). Oba wyniki podałem przy opisie tej maszyny i jej rozbudowy do 64 GB. Żadne porównanie dwóch programów tego nie wyłapie, bo to nie jest własność programu.
Kiedy wybór interfejsu jest wyborem kształtu maszyny
Usługa w sieci albo program na pulpicie
Zostaje pytanie, które po odjęciu warstwy silnika faktycznie się rozstrzyga. Model ma być usługą w sieci, do której kieruje się inne programy, albo programem na biurku, w którym się z nim rozmawia. To są dwa różne kształty i jeden z nich wyklucza drugi dopiero wtedy, gdy maszyna jest jedna.
U mnie jest to usługa: silnik odpowiada na maszynie bez ekranu, przed nim stoi brama API, a klienci wpisują jej adres i nie wiedzą, który model jest pod spodem. Ktoś, kto chce przede wszystkim porozmawiać z modelem na własnym laptopie, wybiera inny kształt i ta sama biblioteka obsłuży go równie dobrze. Pytanie „co lepsze” nie ma tu odpowiedzi, bo dotyczy dwóch różnych zastosowań tej samej rzeczy.
Połowa tytułu bez pomiaru
Sekcja ograniczeń jest tu dłuższa niż zwykle, bo dotyczy połowy tytułu.
- LM Studio znam z używania, nie z pomiaru. Uruchamiałem je u siebie wcześniej, nie mierzyłem go wtedy i nie mam dziś tej instalacji, więc nie ma w tym tekście porównania prędkości, wygody, listy funkcji ani jakości pobierania modeli. Podałbym je dopiero wtedy, gdy zmierzę je tak samo jak silnik: na tej samej maszynie, na tych samych plikach modeli.
- Nic tutaj nie mówi, że LM Studio nie nadaje się na serwer. Ma wersję na Linuksa i narzędzie wiersza poleceń. O żadnym z nich nie wypowiadam się w tym tekście, bo nie mam z nich pomiaru.
- Data 16 maja 2026 i numer zgłoszenia nie są moim pomiarem. To zgłoszenie do llama.cpp, które podałem już wcześniej razem ze źródłem.
- Nie podaję ceny żadnego z tych programów. Nie mam na nią źródła z datą, które czytelnik mógłby dziś sprawdzić.
- Liczby pamięci i prędkości dotyczą jednej maszyny. Jedna konfiguracja, jedno firmware, jedna seria pomiarów z września i października 2026, a nie klasa urządzeń.
- To nie jest miara oszczędności czasu. Nie mam jej zmierzonej dla żadnej ze swoich dziedzin i wybór interfejsu jej nie przybliża.

