
Kategoria: Lokalne AI
„Ryzen AI 9 HX 470, 64 GB. Co z tego faktycznie uruchomię?” Karta katalogowa odpowiada liczbą rdzeni, a decyduje zupełnie inna liczba. Na tej maszynie pracuję codziennie i cała moja seria pomiarów powstała właśnie na niej, więc odpowiedź mam z własnego dysku, nie z recenzji.
Wszystkie liczby poniżej pochodzą z jednej maszyny: AMD Ryzen AI 9 HX 470, 24 rdzenie, zintegrowana grafika Radeon 890M, dysk NVMe 1 TB. Prędkości generowania to seria pomiarów z września 2026 na dwudziestu trzech modelach, jeszcze przy 32 GB pamięci. Obserwacje po rozbudowie pochodzą z października 2026, kiedy te same 32 GB zamieniłem na dwa moduły SODIMM po 32 GB.
Co w tej maszynie decyduje o modelach
Rdzenie są tu najmniej ciekawą pozycją. Modele liczą się na grafice, a grafika w tym procesorze nie ma własnych gigabajtów.
Pamięć jest jedna i dzieli ją z grafiką
Radeon 890M pożycza pamięć systemową i firmware wycina mu z niej okno o stałym rozmiarze. U mnie to około 19 GB (odczyt, październik 2026). Ta liczba, nie suma zainstalowanej pamięci i nie liczba rdzeni, wyznacza górny pułap modelu liczonego na grafice. Dopóki wagi mieszczą się w oknie, przeniesienie warstw przyspiesza odpowiedź około 3-6 razy (pomiar z mojej maszyny); po przekroczeniu okna nadwyżka liczy się na magistrali pamięci. Nie znaczy to, że większy plik zawsze przegrywa: w mieszance ekspertów na jeden token przelicza się około 3 miliardów parametrów, więc pliki 21 i 22,8 GB mimo przekroczenia okna osiągają u mnie 30,4 i 24,17 tokena na sekundę. O przepustowość pamięci opiera się dopiero model gęsty, bo ten w każdym kroku przelicza wszystkie wagi. Reszta pamięci idzie na system, notatnik rozmowy i usługi w tle, a Ubuntu Server w instalacji minimalnej zajmuje z tego około 400 MB (pomiar opublikowany) wobec 4-6 GB na Windowsie.
Co ta maszyna uruchamia i jak szybko
Dwadzieścia trzy modele dają trzy wyraźnie rozdzielone grupy wyników, a granica nie przebiega po rozmiarze pliku.
Od 45,7 do około 3,5 tokena na sekundę
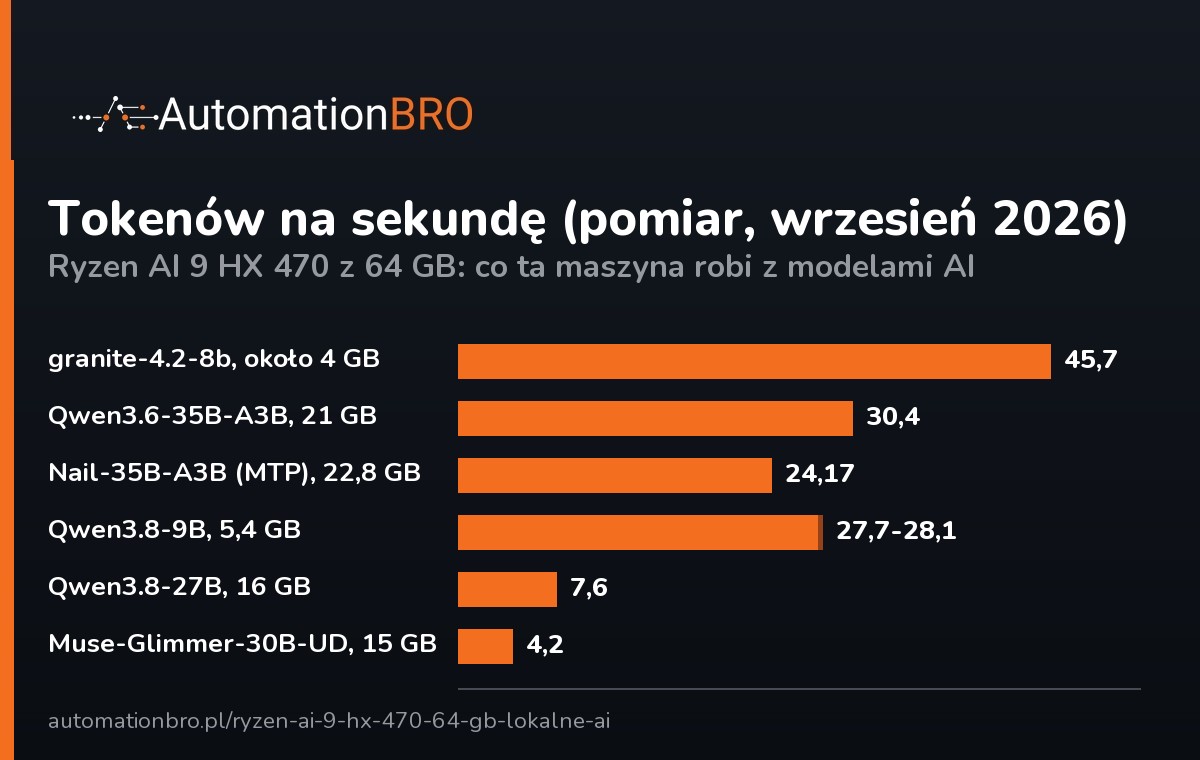
| Klasa modelu | Przykład i rozmiar pliku | Tokenów na sekundę (pomiar, wrzesień 2026) |
|---|---|---|
| Gęsty do 9 mld parametrów | granite-4.2-8b, około 4 GB | 45,7 |
| Mieszanka ekspertów, około 3 mld aktywnych | Qwen3.6-35B-A3B, 21 GB | 30,4 |
| Mieszanka ekspertów, około 3 mld aktywnych | Nail-35B-A3B (MTP), 22,8 GB | 24,17 |
| Gęsty do 9 mld parametrów | Qwen3.8-9B, 5,4 GB | 27,7-28,1 |
| Gęsty powyżej 9 mld, długi kontekst | Qwen3.8-27B, 16 GB | 7,6 |
| Gęsty powyżej 9 mld, długi kontekst | Muse-Glimmer-30B-UD, 15 GB | 4,2 |
Jedenaście z trzynastu wierszy z mieszanką ekspertów mieści się w przedziale 21-33 tokena na sekundę, a dwa spadają do 16,3 i 17,86, oba z „35B” w nazwie, co pokazuje, że sama nazwa nic tu nie rozstrzyga: liczy się, ile parametrów model aktywuje na jeden token. W przebiegach z długim kontekstem każdy wiersz gęsty powyżej 9 mld parametrów schodzi do 11,3 tokena na sekundę lub niżej, przy czym gemma-4-12b na krótkim, rozgrzanym zapytaniu dochodzi u mnie do 34 tokenów na sekundę. Największy plik, jaki na tej maszynie uruchomiłem, ma 22,8 GB. Jak dobieram model pod ten sprzęt, rozpisałem w tekście o tym, jaki model AI uruchomisz lokalnie na mini PC.
Gdzie 64 GB przesuwa granicę
Rozbudowa dała przy okazji rzecz rzadką w domowych testach: ten sam sprzęt zmierzony w dwóch stanach pamięci, bez żadnej innej zmiany pomiędzy nimi.
Notatnik rozmowy przestał być resztkami
Przy 32 GB pliki w okolicach 21 GB wchodziły do pamięci bez problemu, tylko że na notatnik rozmowy zostawało po nich tak mało, iż ręcznie schodziłem z limitem do 16 tys. tokenów. Po wymianie modułów ten limit podniosłem do 64-128 tys. tokenów, a w części konfiguracji do 256 tys., i zapis na dysk wymiany zniknął z całej serii pomiarów (obserwacje z października 2026). Zmieniła się też praca z wieloma modelami: zimny start zajmował 45 s, a teraz przełączenie jest prawie natychmiastowe, dopóki wagi leżą w cache stron. Pełne porównanie obu stanów pamięci, z tabelą, zrobiłem w tekście o tym, co zmieniła rozbudowa z 32 na 64 GB.
Czego dołożenie pamięci nie dało
To jest część, którą najłatwiej kupić sobie w głowie przed zakupem i nie potwierdziła się ani w jednym pomiarze.
Okno grafiki i tokeny zostały bez zmian
Okno pamięci dla grafiki miało około 19 GB przy 32 GB w maszynie i ma około 19 GB przy 64 GB (odczyt przed i po, październik 2026). Rozmiar okna jest wpisany w firmware i nie jest ułamkiem tego, co włożysz do slotów, więc po podwojeniu pamięci na grafice mieści się dokładnie tyle samo; opisałem to osobno w tekście o tym, dlaczego dołożenie pamięci nie powiększyło okna grafiki. Prędkość generowania również została na swoim miejscu. Różnica między obiema konfiguracjami nie przekroczyła jednego procenta, a tyle moja metoda pomiaru i tak nie rozstrzyga. Pamięć nie przyspiesza tokenów. Broni tylko prędkości, którą już masz, bo usuwa scenariusz, w którym dane lecą na dysk wymiany i generowanie spada o rząd wielkości (szacunek).
Ile pobiera i ile kosztuje utrzymanie
Przy tej klasie sprzętu rachunek za prąd okazuje się mniejszy od intuicji, a cena zakupu większa od oczekiwań wobec mini PC.
3-8 W w spoczynku, około 900 EUR za całość
Cała maszyna pobiera 3-8 W w stanie jałowym i około 130 W pod pełnym obciążeniem, a 130 W pojawia się tylko wtedy, gdy model faktycznie generuje odpowiedź, czyli przez kilkanaście lub kilkadziesiąt sekund na zapytanie. Sprzęt w tej konfiguracji kosztuje w Europie około 900 EUR. Pełne wyliczenie rachunku, z czterema scenariuszami i dwiema stawkami za kilowatogodzinę, jest w tekście o tym, ile prądu zużywa domowy serwer AI.
Jeden model naraz i jedna moc obliczeniowa
Silnik w trybie routera utrzymuje w pamięci jeden model. Gdy przychodzi zapytanie do innego, bieżący jest zwalniany, a nowy ładowany, i zimny start trwa 30-60 sekund. Zmierzone wyżej 45 s mieści się w tym przedziale; na 64 GB po prostu rzadziej do niego wracam, bo system trzyma wagi w nieużywanej pamięci. Sama pamięć nie zmienia też tego, że zapytania obsługują się po kolei. Dwa duże modele zmieszczą się obok siebie, tylko że układ liczący jest w tej maszynie jeden i drugie zapytanie czeka na pierwsze. Warstwy oprogramowania, które to porządkują, opisałem w tekście o tym, jak uruchomić lokalny model AI na Ubuntu Server.
Nie porównałem tego procesora z żadnym innym. Mam jedną maszynę, więc każde „kontra” w tym tekście byłoby przepisaniem cudzej recenzji, a nie pomiarem.
Wszystkie prędkości powyżej dotyczą generowania. Czasu przetwarzania zapytania nie mam w żadnym przebiegu, a przy długim kontekście to on decyduje o tym, kiedy pojawi się pierwszy token. Nie przeliczyłem też, ile dodatkowa pamięć kosztuje w prądzie: liczby poboru pochodzą z pomiarów przed rozbudową.
Nie mam wreszcie żadnej liczby oszczędzonego czasu dla tej maszyny i nie wstawię tu szacunku w jej miejsce.
Zestaw pomiarów dla tej maszyny, zrobiony we wrześniu 2026 jeszcze na 32 GB, jest publiczny: 23 wiersze w pliku CSV oraz skrypt pomiarowy w repozytorium local-llm-speed-igpu na GitHubie. Repozytorium jest w języku angielskim.

