
Kategoria: Automatyzacja i autonomia
„Jeden duży workflow czy wiele małych?” Odpowiadam na to stanem własnej bazy, nie zasadą z poradnika.
Pracuję na jednej instancji n8n uruchomionej na własnym serwerze domowym, z bazą PostgreSQL pod spodem. Workflow jest w tym narzędziu pojedynczym rysunkiem złożonym z połączonych bloków. Blok może wywołać inny workflow, który zachowuje się wtedy jak funkcja: otrzymuje dane, wykonuje swoje zadanie i zwraca wynik. Zarówno te połączenia, jak i wielkość każdego rysunku odczytałem bezpośrednio z bazy 29 i 30 października 2026.
Ile moich workflow nie uruchamia się samodzielnie
W bazie znajdują się 223 workflow, a rozbicie samej tej liczby jest przedmiotem osobnego tekstu o tym, co znaczy ponad 150 workflow w n8n. Odnalazłem w nich trzy rodzaje bloków, które budują połączenia między workflow.
| Rodzaj bloku | Liczba | Co oznacza |
|---|---|---|
| start po wywołaniu przez inny workflow | 79 | wejście do części składowej |
| wywołanie innego workflow | 79 | miejsce, z którego ktoś woła |
| udostępnienie workflow agentowi AI | 43 | część składowa wybierana przez model |
Pierwszy wiersz jest podstawą całego wywodu. Siedemdziesiąt dziewięć bloków to siedemdziesiąt dziewięć miejsc oczekujących wyłącznie na wywołanie: bez zegara, bez adresu, bez kliknięcia. Przy 223 workflow w bazie oznacza to, że mniej więcej jedna trzecia zbioru nie jest automatyzacją, lecz jej częścią składową. Pozostałe wyzwalacze, czyli zegar, adres i okno czatu, policzyłem w tekście o tym, co uruchamia automatyzację.
Dlaczego dwie pierwsze wartości są równe
Siedemdziesiąt dziewięć wejść i siedemdziesiąt dziewięć wywołań. Nie wyciągam z tego wniosku, że każda część składowa ma dokładnie jednego wołającego, ponieważ równie dobrze jedna może być wywoływana z pięciu miejsc, a cztery inne z żadnego. Rozstrzygnięcie wymaga dopasowania wywołań do celów po identyfikatorach, czego nie wykonałem. Podaję zatem obie wartości i zatrzymuję się przed wnioskiem.
Jakiej wielkości są te rysunki
Jest to druga, niezależna odpowiedź na to samo pytanie, a zarazem mocniejsza, ponieważ nie opiera się na żadnym założeniu o grafie połączeń. Policzyłem bloki w każdym z 223 workflow. Łącznie jest ich 3 449, co daje średnio 15,5 bloku na workflow. Średnia jest tu jednak myląca i warto zobaczyć dlaczego.
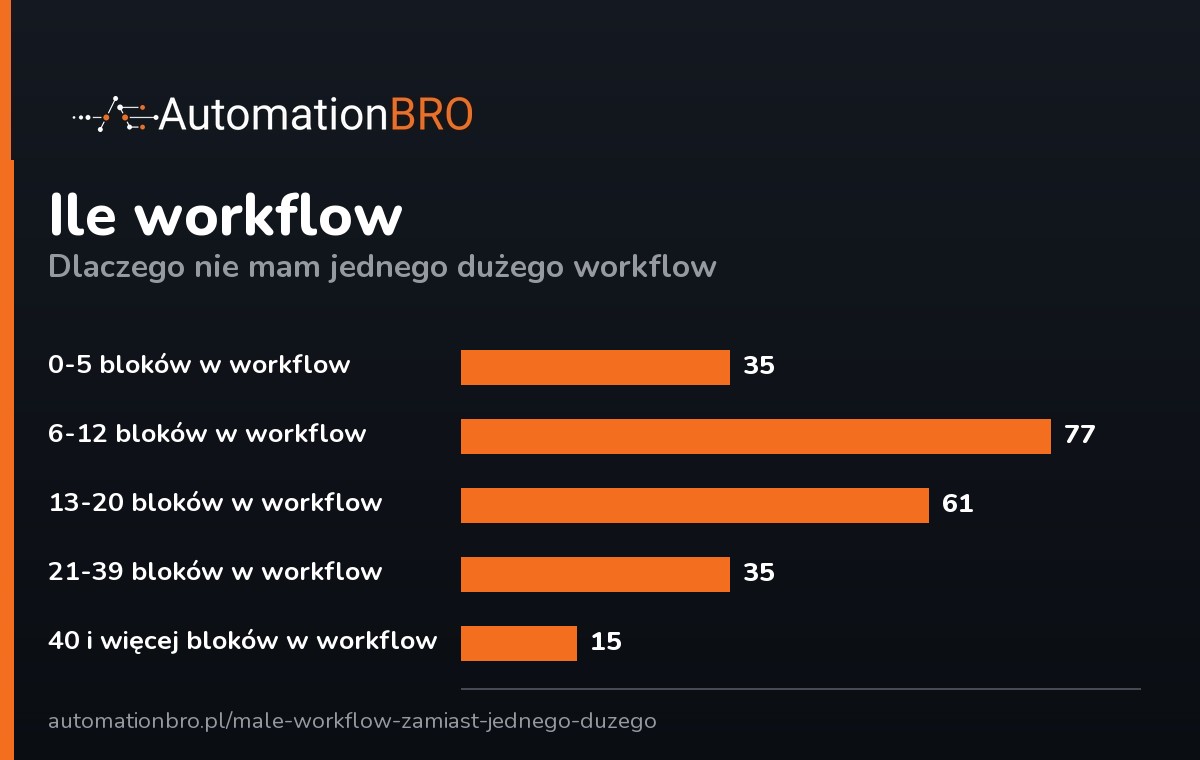
| Bloków w workflow | Ile workflow | Udział |
|---|---|---|
| 0-5 | 35 | 16% |
| 6-12 | 77 | 34% |
| 13-20 | 61 | 27% |
| 21-39 | 35 | 16% |
| 40 i więcej | 15 | 7% |
Najważniejszą wartością w tym zestawieniu nie jest średnia, lecz mediana: 12 bloków. Połowa moich automatyzacji to rysunek, który widzę w całości na jednym ekranie. Siedemdziesiąt osiem procent zawiera dwadzieścia bloków lub mniej. Zbiór nie jest więc „dużym systemem”, tylko dużą liczbą niewielkich rozwiązań.
Siedem procent, które tej zasady nie przestrzega
Piętnaście workflow zawiera czterdzieści bloków lub więcej, a największy sześćdziesiąt dwa. Istotniejsza jest jednak proporcja: te piętnaście workflow, czyli 7% zbioru, mieści 799 z 3 449 bloków, a więc niemal jedną czwartą wszystkiego, co zbudowałem. Nie są to zatem wyjątki potwierdzające regułę, lecz miejsca, w których reguła przegrała, i to właśnie tam najdłużej szukam błędów. Tekst nie opisuje więc dobrze uporządkowanego zbioru, tylko zasadę, której sam nie dotrzymuję w jednym przypadku na czternaście.
Co ten podział rzeczywiście daje
Nie oszczędność miejsca i nie elegancję rysunku, lecz trzy rzeczy w następującej kolejności.
Jedno miejsce na jedną zmianę. Sposób, w jaki wysyłam sobie powiadomienie w Telegramie, jest u mnie jednym workflow, a nie trzydziestoma kopiami tego samego bloku. Zmiana treści albo kanału oznacza jedną modyfikację. Ten sam argument opisałem warstwę niżej, przy ośmiu bazach danych z jedną drogą dostępu, gdzie dotyczy on dostępu do danych, podczas gdy tutaj dotyczy samego przepływu, ale mechanizm jest identyczny.
Awaria zostaje na miejscu. Gdy część składowa przestaje działać, przestaje działać ta jedna rzecz, a nie cały łańcuch, w którym była osadzona.
Rysunek da się przeczytać po pół roku. Jest to korzyść najmniej efektowna i w praktyce najważniejsza. Rysunek złożony z czterdziestu bloków po trzech miesiącach jest dla mnie obcy, a takich mam piętnaście. Rysunek z dwunastu bloków, który wywołuje cztery nazwane części, czyta się jak zdanie.
Czwarta korzyść pojawiła się niezamierzenie
Czterdzieści trzy bloki udostępniają workflow agentowi AI jako narzędzie do wyboru. Aby było to w ogóle możliwe, workflow musi być niewielkim, nazwanym fragmentem o jednym wejściu i jednym wyniku, czyli dokładnie tym, co powstaje przy dzieleniu na części. Podzieliłem zbiór z powodów porządkowych, zanim pojawiło się cokolwiek do podłączenia pod model, i okazało się, że był to warunek wstępny. Pisałem o tym, dlaczego mój cyfrowy bliźniak nie jest agentem AI, a granica przebiega właśnie tędy: model wybiera spośród gotowych części, a nie tworzy nowych. To, które modele dokonują tego wyboru, policzyłem osobno: 229 bloków, z czego 10 na mojej maszynie.
Ile ten podział kosztuje
Płacę za niego trzema rzeczami i żadna z nich nie jest drobna.
Przeskakiwanie między ekranami. Prześledzenie jednej sprawy od początku do końca wymaga otwarcia czterech rysunków zamiast jednego. Przy szukaniu błędu jest to realna strata czasu.
Liczba w bazie przestaje cokolwiek znaczyć. Zdanie „mam 223 workflow” brzmi inaczej, gdy jedna trzecia z nich to części składowe, a mediana wielkości wynosi dwanaście bloków. Dlatego nie podaję tej liczby bez rozbicia.
Część składowa bez wołającego zostaje na zawsze. Po usunięciu elementu, który ją wywoływał, pozostaje sierota: fragment, który nigdy się nie uruchomi i o sobie nie przypomni. Nie mam procedury wykrywającej takie przypadki. Dwa workflow w bazie zawierają zero bloków, czyli są pustymi rysunkami rozpoczętymi kiedyś i nigdy nieukończonymi, o których nic mi nie przypomniało aż do tego pomiaru.
Kiedy nie dzielę
Nie dzielę wtedy, gdy część miałaby jednego wołającego i nigdy nie otrzyma drugiego, ponieważ podział dodaje wówczas ekran i nie daje nic w zamian. Nie dzielę również rozwiązań krótkich: automatyzacja złożona z sześciu bloków pozostaje jednym rysunkiem, nawet jeśli dałoby się ją rozciąć, a takich, do pięciu bloków, mam trzydzieści pięć. Stosowana przeze mnie zasada brzmi: dzielę wtedy, gdy fragment ma własną nazwę, którą potrafię wypowiedzieć jednym zdaniem.
Liczba bloków nie jest miarą złożoności
- Zliczam bloki, nie workflow. Jeden workflow może zawierać kilka bloków wywołania. Zdanie o jednej trzeciej zbioru opieram na 79 blokach wejścia, ponieważ takich bloków workflow ma zwykle jeden, ale jest to założenie, a nie zmierzony podział.
- Rysunek z dwunastu bloków, w którym dwa stanowią rozgałęzienie, a jeden pętlę, jest trudniejszy niż rysunek z dwudziestu ustawionych w jednej linii. Mierzę rozmiar, a nie trudność, i nie przedstawiam tego jako to samo.
- Nie wiem, czy największe workflow są kopiami. Pięć workflow zawiera dokładnie pięćdziesiąt dwa bloki, trzy dokładnie sześćdziesiąt jeden, a trzy dokładnie sześćdziesiąt dwa. Powtarzające się identyczne wartości wyglądają na kopie jednego rozwiązania, lecz tego nie sprawdziłem i tego nie twierdzę.
- Nie wiem, ile jest sierot. Nie sprawdziłem, które części składowe nie mają już żadnego wołającego. Wiem jedynie, że dwa rysunki są całkowicie puste.
- Nie mierzę opłacalności podziału. Nie dysponuję wartością opisującą czas szukania błędu ani liczbę awarii przed podziałem i po nim. Pozostaje doświadczenie i tak też jest to tutaj nazwane.
- Opisują dwa dni. Pomiar z 29 i 30 października 2026.

