
Kategoria: Automatyzacja i autonomia
Zakładałem, że skoro dysponuję własnym modelem lokalnym, to moje automatyzacje z niego korzystają. Nie sprawdzałem tego założenia, ponieważ wydawało się oczywiste. Odczyt bloków modeli w bazie pokazał co innego, a drugi, dokładniejszy odczyt pokazał jeszcze mniej niż pierwszy.
Pracuję na jednej instancji n8n uruchomionej na własnym serwerze domowym, z bazą PostgreSQL pod spodem, oraz na osobnej maszynie z modelami lokalnymi, którą opisałem przy uruchamianiu lokalnego modelu przez llama.cpp i LiteLLM. W n8n model AI nie jest ustawieniem całego workflow, lecz osobnym blokiem dołączanym do bloku agenta, dlatego takie bloki można policzyć pojedynczo. Odczytałem je bezpośrednio z bazy 29 i 30 października 2026 i wszystkie liczby w tym tekście są pomiarem z tych dwóch dni.
Pełny rozkład: 229 bloków, w których pracuje model
W 223 workflow znajduje się 229 bloków związanych z modelem AI. Podane wartości opisują liczbę bloków, a nie liczbę workflow, ponieważ pojedynczy workflow może zawierać ich sześć. Pochodzenie samej liczby 223 wyjaśniam w tekście o tym, co znaczy ponad 150 workflow w n8n.
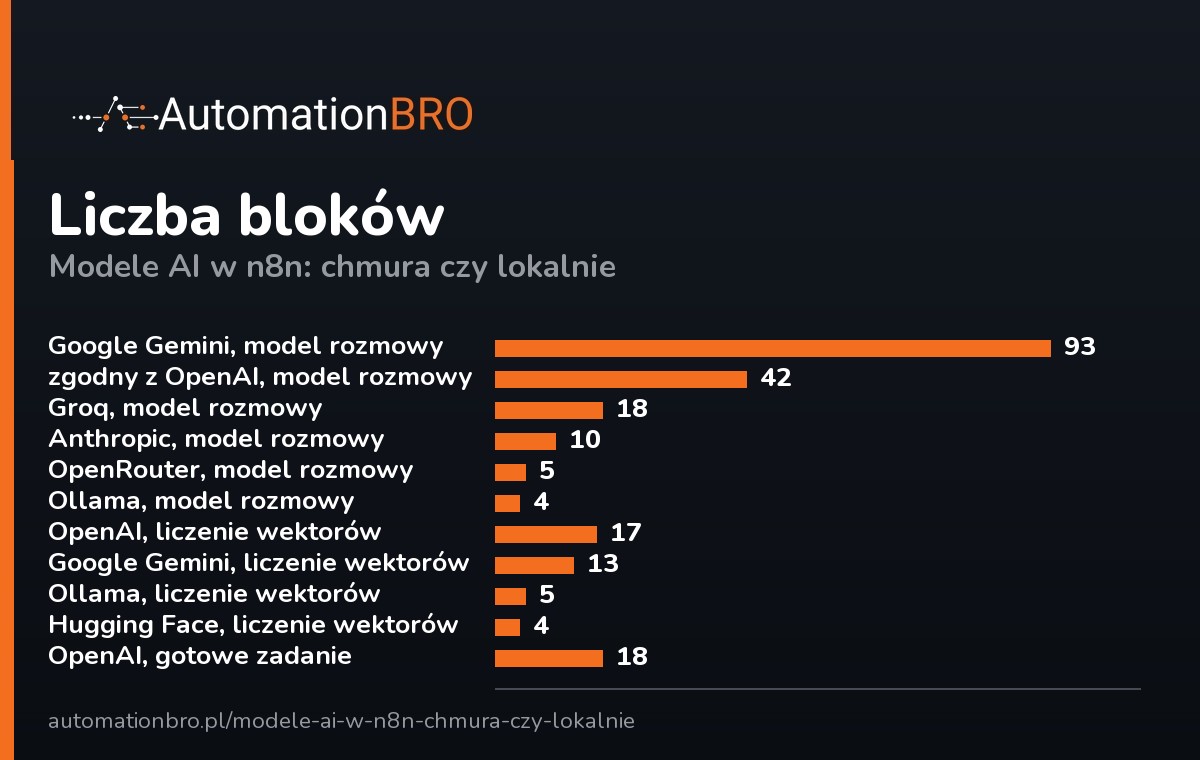
| Rodzaj bloku | Dostawca | Liczba | Gdzie liczy |
|---|---|---|---|
| model rozmowy | Google Gemini | 93 | chmura |
| model rozmowy | zgodny z OpenAI | 42 | chmura (41) + moja maszyna (1) |
| model rozmowy | Groq | 18 | chmura |
| model rozmowy | Anthropic | 10 | chmura |
| model rozmowy | OpenRouter | 5 | chmura |
| model rozmowy | Ollama | 4 | moja maszyna |
| liczenie wektorów | OpenAI | 17 | chmura |
| liczenie wektorów | Google Gemini | 13 | chmura |
| liczenie wektorów | Ollama | 5 | moja maszyna |
| liczenie wektorów | Hugging Face | 4 | chmura |
| gotowe zadanie OpenAI | OpenAI | 18 | chmura |
Z zestawienia wynika wniosek, którego się nie spodziewałem: 10 bloków na 229 pracuje na mojej maszynie, czyli cztery procent. Pozostałe 219 wysyła dane do cudzego centrum danych. Zbudowałem maszynę do lokalnego AI, opisałem, jaki model wybrać do mini PC, zmierzyłem jej prędkości, a mimo to w warstwie, która wykonuje właściwą pracę, nie stała się ona rozwiązaniem domyślnym.
Jeden blok wskazuje na moją bramkę
Blok „OpenAI” w n8n nie dowodzi użycia OpenAI, ponieważ ten sam blok obsługuje każdą usługę zgodną z tym interfejsem, w tym własną bramkę na własnym serwerze. Sprawdziłem to, ponieważ gdyby połowa z 42 takich bloków wskazywała na moją maszynę, cała teza tego tekstu byłaby nieprawdziwa. W instancji skonfigurowane są dwa dostępy tego typu: jeden do OpenAI i jeden do mojej bramki. Mojej używa jeden blok na 42. W dwudziestu trzech blokach pole nazwy dostępu pozostaje puste, więc o nich nie twierdzę niczego. Dwadzieścia siedem spośród tych 42 ma natomiast wpisaną nazwę modelu, która występuje wyłącznie w OpenAI, i to wystarczy, żeby nie szukać dla siebie usprawiedliwienia.
Dlaczego bloków modeli jest więcej niż agentów
Bloków agenta AI jest 97, a bloków modelu rozmowy 172. Jeden agent może mieć dołączony więcej niż jeden model, na przykład zapasowy na wypadek braku odpowiedzi pierwszego, i u mnie często go ma. Dodatkowo 23 łańcuchy LLM również wymagają modelu, choć agentami nie są. Obie wartości nie muszą się więc zgadzać i nie próbuję ich uzgadniać. Mediana wielkości workflow wynosi dwanaście bloków, a opisałem ją przy tym, dlaczego nie mam jednego dużego workflow.
Gemini wygrał dostępnością, nie jakością
Dziewięćdziesiąt trzy bloki jednego dostawcy nie są wynikiem porównania modeli. W ten sposób powstaje wybór domyślny: raz skonfigurowany dostęp zadziałał, więc każdy kolejny workflow otrzymywał to samo, ponieważ było to o jedno kliknięcie bliżej. Jest to wniosek z mojej pracy, a nie pomiar, natomiast rozkład, w którym jeden dostawca ma więcej bloków niż wszyscy pozostali razem, odpowiada dokładnie temu, jak wygląda nawyk.
Ile to kosztuje
Każde z tych 219 miejsc płaci za tokeny przy każdym uruchomieniu. Opisałem osobno, ile kosztują tokeny agenta AI i jak ten rachunek rośnie, gdy agent wywołuje sam siebie w pętli. W tym miejscu wystarczy stwierdzić, że liczba bloków modeli jest lepszym przybliżeniem przyszłego rachunku niż liczba workflow.
Model lokalny w n8n to nie ten model, który zmierzyłem
Ta część odczytu zaskoczyła mnie najbardziej. Dziewięć bloków Ollamy korzysta z modelu llama3.1 do rozmowy oraz z nomic-embed-text do liczenia wektorów. Żaden z nich nie jest modelem, którego prędkości mierzyłem i publikowałem dla swojej maszyny do lokalnego AI. Warstwa automatyzacji otrzymała model lokalny wcześniej, innym kanałem, i nigdy go nie zaktualizowałem, ponieważ działał poprawnie.
Jest to, moim zdaniem, dokładniejszy opis rzeczywistego domu z automatyzacją niż jakikolwiek plan architektury. Elementy pozostają tam, gdzie je ustawiono, dopóki nie przestaną działać.
Dlaczego lokalny nie jest domyślny
Powodem nie jest jakość modelu, lecz jedna cecha workflow: blok czeka. W rozmowie z modelem obserwuję, jak kolejne słowa pojawiają się na ekranie, i wolniejsza odpowiedź pozostaje znośna. W workflow nie obserwuje jej nikt: blok stoi do chwili otrzymania całego wyniku, a następny blok czeka za nim. Workflow z sześcioma krokami modelu zwielokrotnia tę różnicę sześciokrotnie, a na końcu czeka webhook, który miał odpowiedzieć natychmiast. Webhooków mam czterdzieści i policzyłem je razem z pozostałymi wyzwalaczami.
Druga przyczyna jest bardziej przyziemna: agent nie prosi modelu o tekst, lecz o wywołanie narzędzia w ściśle określonym formacie. Mam 43 bloki, które udostępniają agentowi gotowe workflow do wyboru. Gdy model odpowie prozą zamiast formatem, agent zatrzymuje się, a przy 97 agentach nie jest to przypadek rzadki. Pisałem o tym, czego lokalne AI nie zrobi, i przebiega tam dokładnie ta granica.
Co musiałoby się zmienić
Formułuję trzy warunki i każdy z nich jest konkretny:
- Krok, który nie każe czekać. Zadania zbiorcze przeliczane nocą, przy których nikt nie oczekuje odpowiedzi. Opóźnienie nic tam nie kosztuje. Pięć bloków liczenia wektorów znajduje się już po tej stronie i nie jest to przypadek, ponieważ jest to jedyna praca w całym zbiorze, która rzeczywiście nikogo nie zatrzymuje.
- Powtarzalny format. Model lokalny trafia tam, gdzie wynikiem jest jedno słowo lub jedna etykieta, a nie wywołanie narzędzia z czterema polami.
- Dane, które nie powinny opuścić domu. To jedyny warunek przeważający nad opóźnieniem. Napisałem osobno o AI i danych klienta w chmurze. Moje workflow przetwarzają wyłącznie moje własne dane, więc ten argument nie wymusza u mnie zmiany, natomiast przy danych cudzych wymuszałby ją pierwszego dnia, bez liczenia sekund.
Obecność bloku, nie jego zużycie
- Zliczam bloki, a nie workflow ani uruchomienia. Blok modelu w wyłączonym workflow liczy się tak samo jak blok pracujący co pięć minut. Spośród 223 workflow włączonych jest 119, więc część z tych 229 bloków nie uruchomiła się od miesięcy. Liczbę rzeczywistych uruchomień podaje dziennik przebiegów, który obejmuje czternaście dni.
- Mierzę obecność, a nie zużycie. Jeden blok Gemini w workflow uruchamianym co minutę zużywa więcej niż trzydzieści bloków w rozwiązaniach wyłączonych. Rozkład bloków nie jest rozkładem rachunku.
- Dwadzieścia trzy bloki bez nazwy dostępu. W 23 z 42 bloków zgodnych z OpenAI pole nazwy dostępu jest w odczycie puste. Nie twierdzę ani że wskazują na OpenAI, ani że wskazują na moją bramkę. Gdyby wszystkie 23 wskazywały na moją maszynę, liczba miejsc lokalnych wzrosłaby z 10 do 33 i nadal pozostawałaby mniejszością.
- Nie wymieniam wszystkich nazw modeli. Odczyt zwrócił kilka nazw z usługi OpenRouter, których nie potrafię dopasować do żadnego modelu możliwego do zweryfikowania u dostawcy. Nie przepisuję ich, ponieważ jedna nazwa, której czytelnik nie odnajdzie, podważa zaufanie do całej tabeli. Dotyczy to 5 bloków OpenRouter i 1 bloku zgodnego z OpenAI.
- Nie mierzyłem opóźnienia wewnątrz workflow. Wywód o oczekiwaniu opieram na publikowanych osobno prędkościach modeli oraz na własnej praktyce, a nie na pomiarze czasu kroku w n8n.
- Nic w tym tekście nie porównuje jakości modeli. Rozkład opisuje moje nawyki, a nie to, który model jest lepszy.
- Opisują dwa dni. Pomiar z 29 i 30 października 2026.

